Μια έγκυος γυναίκα στο Μαλάουι λέει ότι έσπασαν τα νερά της. Ένα σύστημα τεχνητής νοημοσύνης, επειδή δεν γνωρίζει αρκετά καλά τη γλώσσα και το τοπικό ιδίωμα, μπορεί να μεταφράσει τη φράση σαν να είπε ότι «πέταξε νερό». Είναι ένα μικρό παράδειγμα ενός προβλήματος που αφορά περίπου 3,4 δισεκατομμύρια ανθρώπους: η τεχνητή νοημοσύνη δεν καταλαβαίνει όλες τις γλώσσες του κόσμου με την ίδια ακρίβεια.
Εξήντα οργανισμοί ανακοίνωσαν τώρα έναν κοινό πενταετή στόχο ώστε άνθρωποι που μιλούν γλώσσες οι οποίες σήμερα υποεκπροσωπούνται στα μοντέλα να μπορούν να χρησιμοποιούν εργαλεία AI στη δική τους γλώσσα και φωνή. Στον συνασπισμό συμμετέχουν, μεταξύ άλλων, οι Anthropic, Amazon, Google, Microsoft, Mistral, Nvidia, OpenAI Foundation και Mozilla Data Collective, μαζί με πανεπιστήμια, κυβερνητικούς φορείς, τη UNICEF και τον Όμιλο της Παγκόσμιας Τράπεζας.
Και εδώ βρίσκεται το μεγαλύτερο πρόβλημα. Τα σημερινά μοντέλα έμαθαν σε μεγάλο βαθμό τη γλώσσα από ό,τι ήταν ήδη διαθέσιμο στο internet. Το internet, όμως, δεν είναι αντιπροσωπευτικό δείγμα του τρόπου με τον οποίο μιλά η ανθρωπότητα. Η επικεφαλής της Mozilla Data Collective το περιέγραψε ως το «αρχικό αμάρτημα» της σημερινής AI: τεράστιες ποσότητες γλωσσικών δεδομένων αντλήθηκαν από το διαδίκτυο, όπου ορισμένες γλώσσες, κοινωνίες και τρόποι ομιλίας είναι συντριπτικά πιο ορατοί από άλλους. «Γιατί να περιμένεις ένα πολιτισμικά αντιπροσωπευτικό σύστημα από κάτι που εκπαιδεύτηκε κυρίως στο Reddit;» ήταν το ερώτημα που έθεσε.
Ο νέος συνασπισμός θέλει να δουλέψει ταυτόχρονα σε τέσσερα επίπεδα: στη δημιουργία ανοικτών γλωσσικών δεδομένων, στην ανάπτυξη καλύτερων μεθόδων αξιολόγησης, στη μετατροπή αυτών των δεδομένων σε μοντέλα και εφαρμογές που δεν θα βρίσκονται μόνο στα χέρια των μεγαλύτερων εταιρειών και, τέλος, σε κανόνες για την ιδιωτικότητα, τη συγκατάθεση και την κυριότητα των δεδομένων από τις ίδιες τις κοινότητες. Η τελευταία παράμετρος είναι κρίσιμη: το ζητούμενο δεν είναι απλώς να συγκεντρωθούν περισσότερες λέξεις, αλλά να μη μετατραπούν οι γλώσσες και οι πολιτισμοί μικρότερων κοινοτήτων σε ακόμη μία πρώτη ύλη που συλλέγεται χωρίς τη συμμετοχή τους.
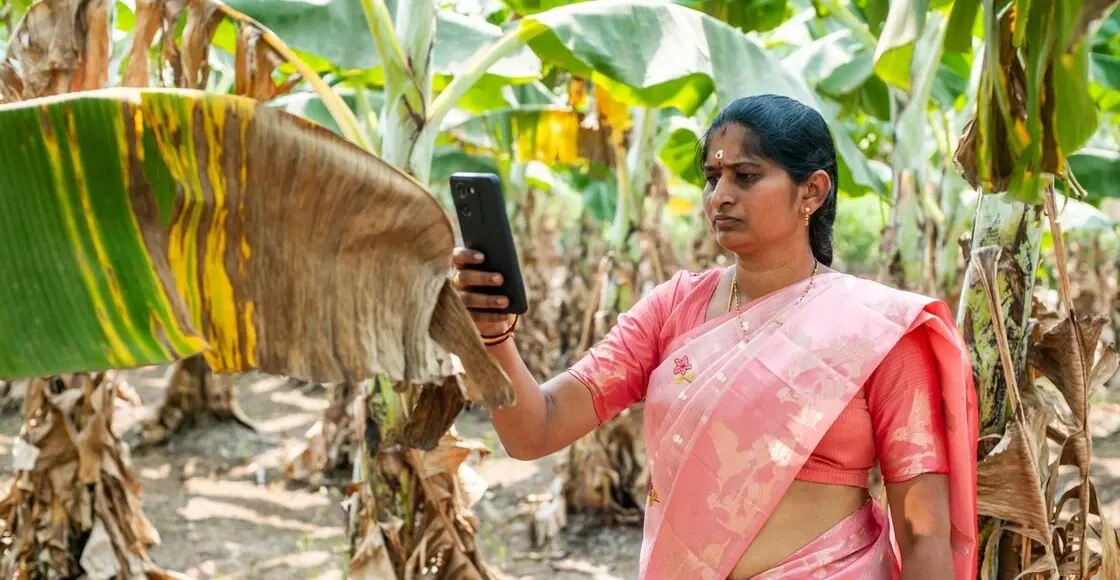
Μια εικόνα για το μέγεθος της δουλειάς δίνει το Project Vaani στην Ινδία. Η Google και το Indian Institute of Science έχουν αναπτύξει ένα πρόγραμμα καταγραφής της πραγματικής ομιλίας ανθρώπων από διαφορετικές περιοχές, ηλικίες και κοινωνικά περιβάλλοντα. Ο μακροπρόθεσμος στόχος είναι να συγκεντρωθούν περισσότερες από 150.000 ώρες ομιλίας από όλη τη χώρα· μέχρι σήμερα έχουν ήδη συλλεχθεί πάνω από 30.000 ώρες από περισσότερους από 155.000 ομιλητές σε 109 γλώσσες και διαλέκτους.
Το σημαντικό είναι ότι δεν καταγράφεται απλώς η «επίσημη» μορφή μιας γλώσσας. Η έρευνα πηγαίνει στις ίδιες τις κοινότητες, ώστε να συλλαμβάνει προφορές, τοπικές παραλλαγές και τον τρόπο με τον οποίο οι άνθρωποι πραγματικά μιλούν μεταξύ τους. Στην Ινδία, όπου περισσότερες από 1.300 γλώσσες χρησιμοποιούνται σε διαφορετικές περιοχές, μια διάλεκτος ή ακόμη και η σημασία μιας λέξης μπορεί να αλλάξει μέσα σε σχετικά μικρή γεωγραφική απόσταση.
Το κενό αναγνωρίζουν πλέον και οι ίδιες οι εταιρείες που αναπτύσσουν τα μεγαλύτερα μοντέλα. Η Anthropic έχει παραδεχθεί ότι τα προϊόντα της υστερούν ιδιαίτερα σε πολλές αφρικανικές γλώσσες και ότι εφαρμογές της AI στην υγεία ή στην εκπαίδευση δεν μπορούν να αποδώσουν πραγματικά αν προηγουμένως δεν λυθεί το γλωσσικό πρόβλημα.
Η συμμαχία βρίσκεται ακόμη στην αρχή: η διακυβέρνησή της, οι συγκεκριμένες δεσμεύσεις των μελών και ο τρόπος με τον οποίο θα συντονιστούν τα διαφορετικά προγράμματα θα καθοριστούν μέσα στον επόμενο χρόνο. Το διακύβευμα, όμως, είναι ήδη σαφές.
Όσο η τεχνητή νοημοσύνη μαθαίνει τον κόσμο από ένα internet στο οποίο ορισμένες γλώσσες υπάρχουν παντού και άλλες σχεδόν καθόλου, η ποιότητα της AI δεν είναι απλώς τεχνικό ζήτημα. Είναι και ζήτημα του ποιος κόσμος καταφέρνει να χωρέσει μέσα στα δεδομένα της.